
ThingsBoard 的性能测试
正文与配图来自原稿。基于官方镜像
thingsboard/tb-ce-performance-test,在 Ubuntu + Docker 上复现多档吞吐测试。
工具镜像示例:thingsboard/tb-ce-performance-test:3.3.3(可按你的 TB 版本换 tag)。
通用压测启动形态:
export TB_INTERNAL_IP=<TB服务器内网IP>
docker run -it --rm --network host --name tb-perf-test \
  --env REST_URL=http://$TB_INTERNAL_IP:8080 \
  --env MQTT_HOST=$TB_INTERNAL_IP \
  --env DEVICE_END_IDX=5000 \
  --env MESSAGES_PER_SECOND=1000 \
  --env ALARMS_PER_SECOND=10 \
  --env DURATION_IN_SECONDS=86400 \
  --env DEVICE_CREATE_ON_START=true \
  thingsboard/tb-ce-performance-test:3.3.3
后续峰值测试常设 DEVICE_CREATE_ON_START=false(设备已建好)。
一、场景 A:仅 Postgres
配置
| 项 | 值 |
|---|---|
| 机器 | 2 核 4G,100G 盘 |
| 设备 | 5000 |
| 负载 | 1000 msg/s MQTT,每条 3 点 → 3000 点/s |
| 库 / 队列 | PostgreSQL,内存队列 |
环境
Ubuntu 20.04,安装 docker / docker-compose:
sudo apt update
sudo apt install docker.io docker-compose
docker-compose(tb-postgres)
version: '3.0'
services:
  mytb:
    image: "thingsboard/tb-postgres"
    network_mode: "host"
    restart: "always"
    volumes:
      - thingsboard-data:/data
      - thingsboard-logs:/var/log/thingsboard
    environment:
      DATABASE_TS_TYPE: "sql"
      TB_QUEUE_TYPE: "in-memory"
      TB_SERVICE_ID: "tb-node-0"
      HTTP_BIND_PORT: "8080"
      TB_QUEUE_RE_MAIN_PACK_PROCESSING_TIMEOUT_MS: "30000"
      TB_QUEUE_RE_MAIN_CONSUMER_PER_PARTITION: "false"
      JAVA_OPTS: " -Xmx2048M -Xms2048M ..."
volumes:
  thingsboard-data:
thingsboard-logs:docker-compose up -d
docker logs -f --tail 500 mytb结果与峰值
基线结果:
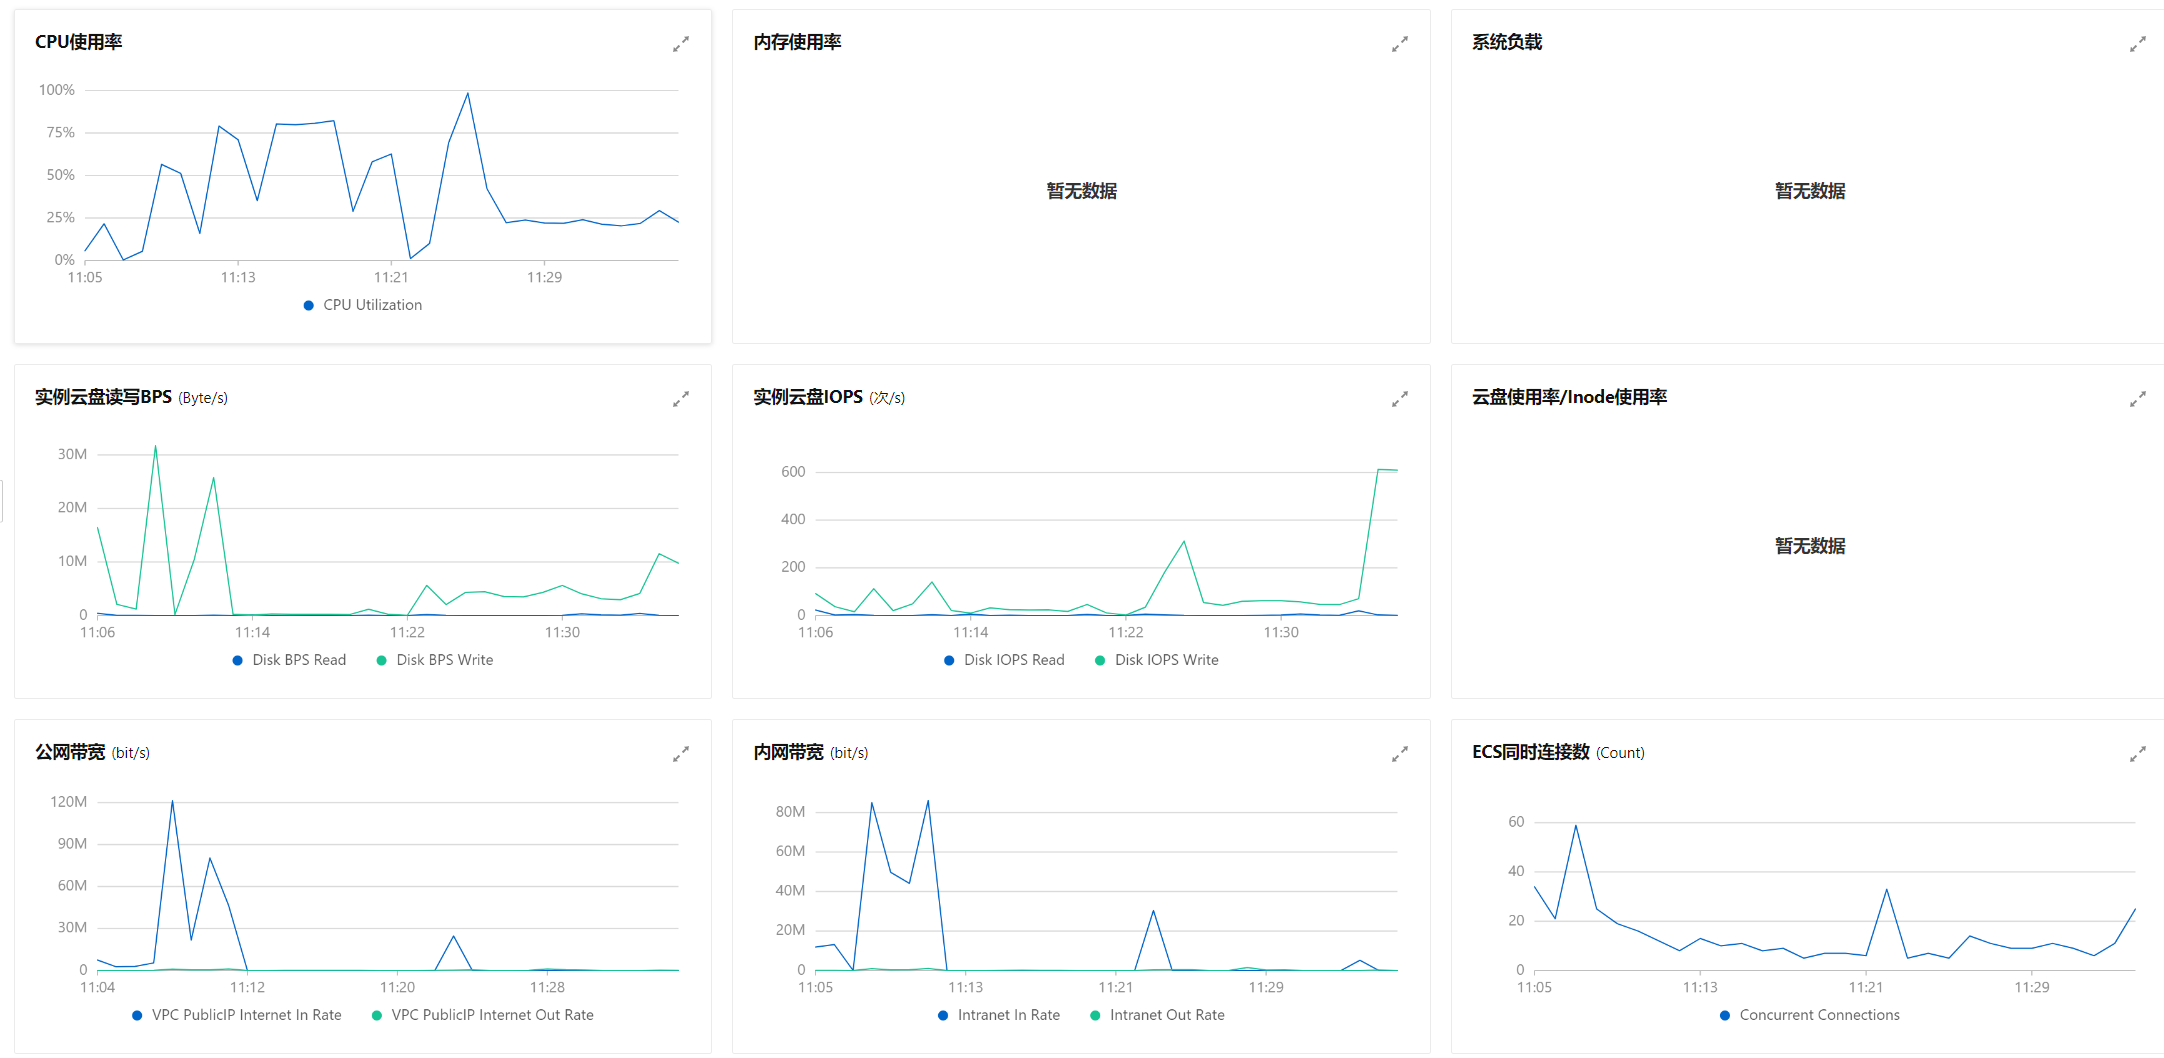
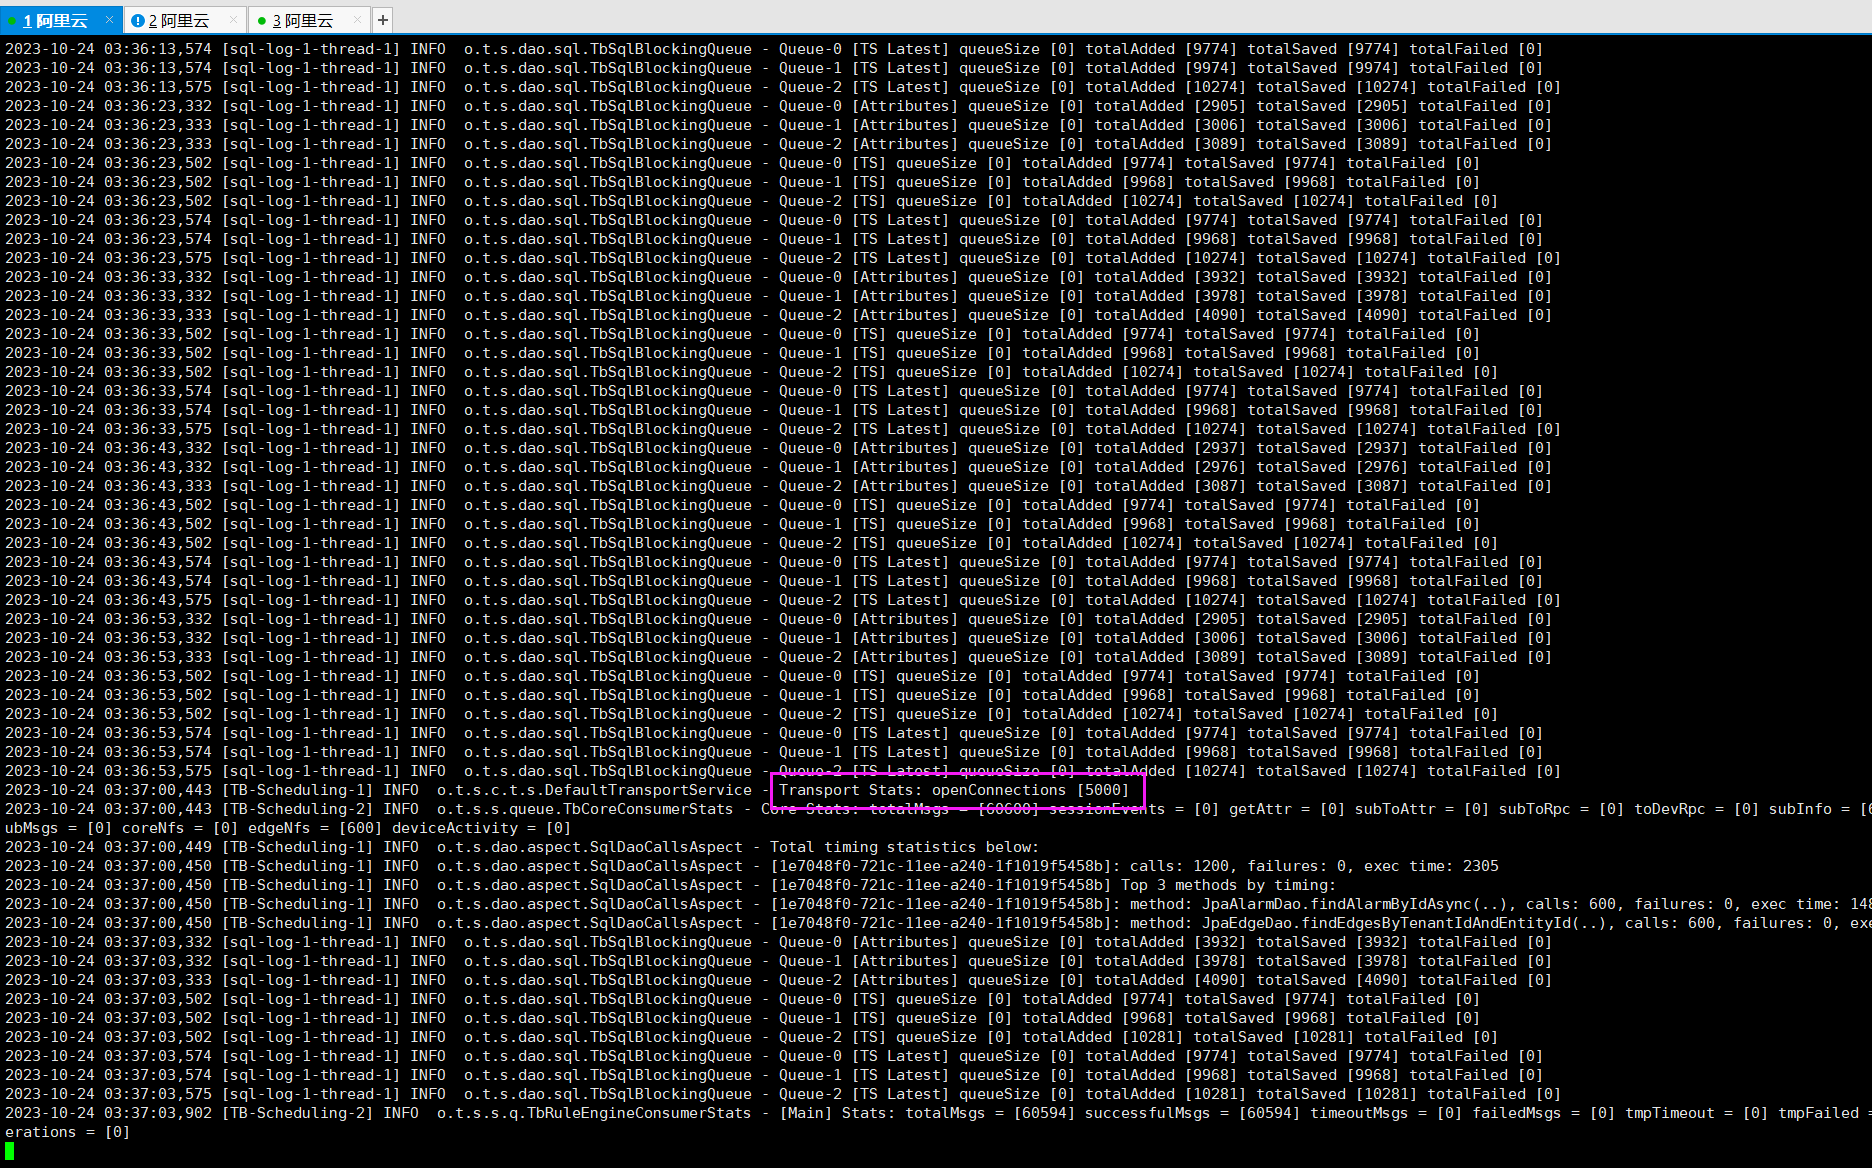
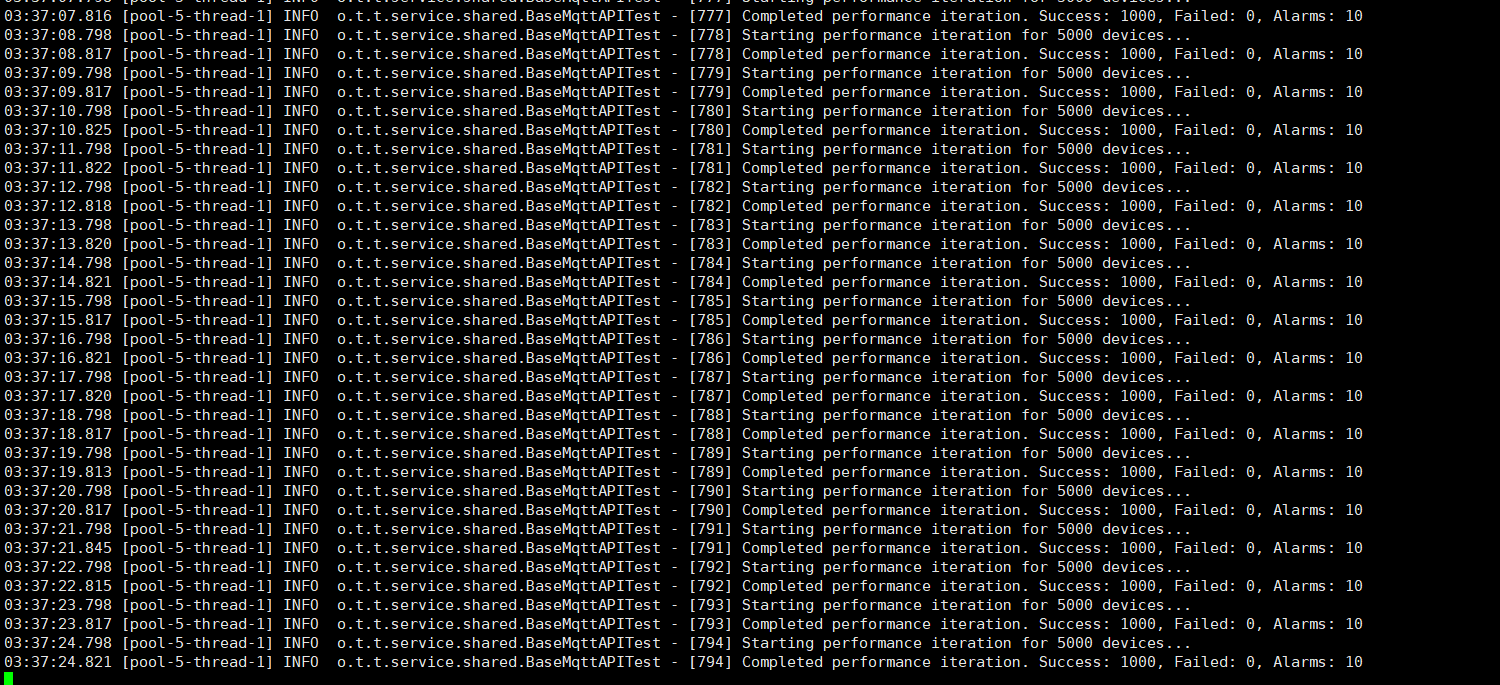
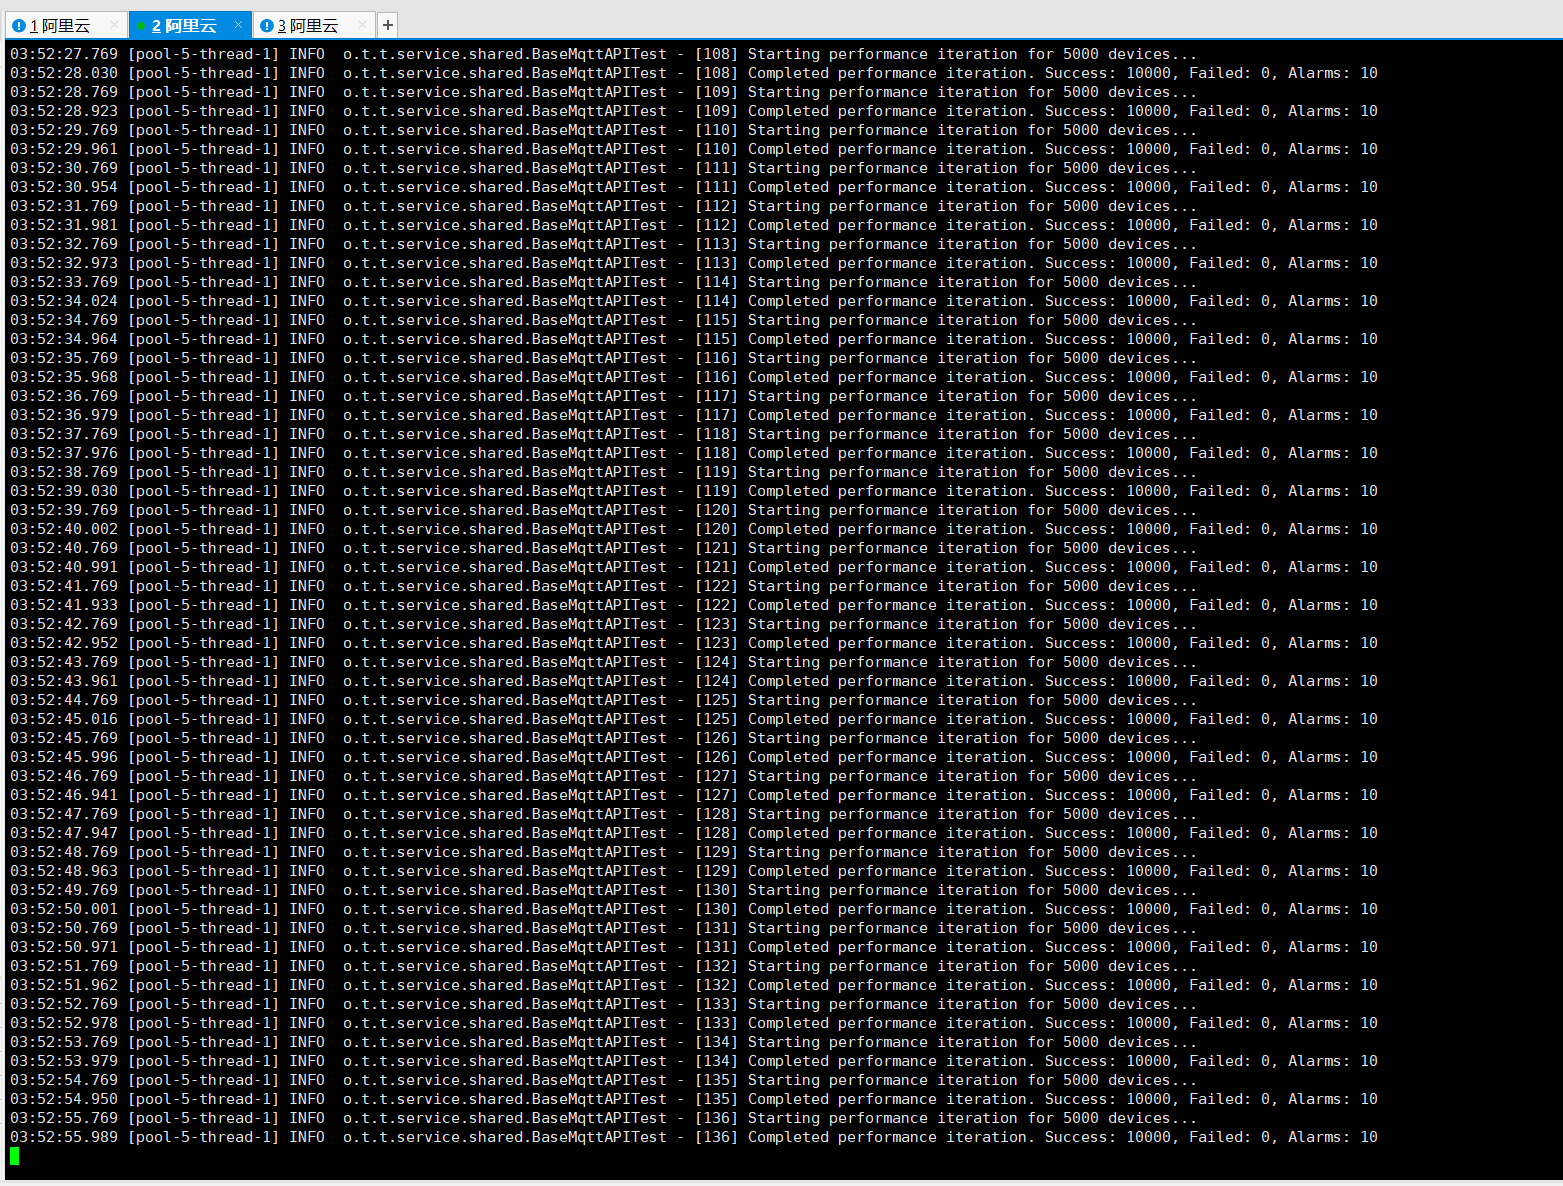
×3 峰值: 3333 msg/s → 约 10000 点/s
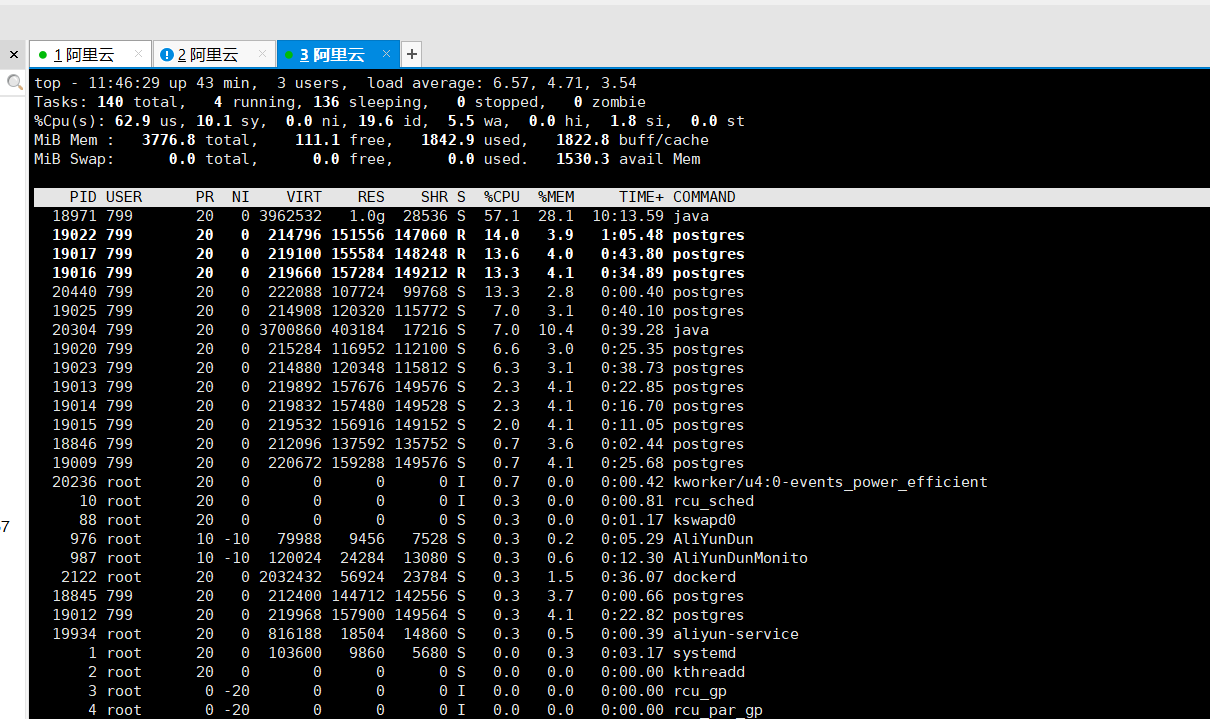
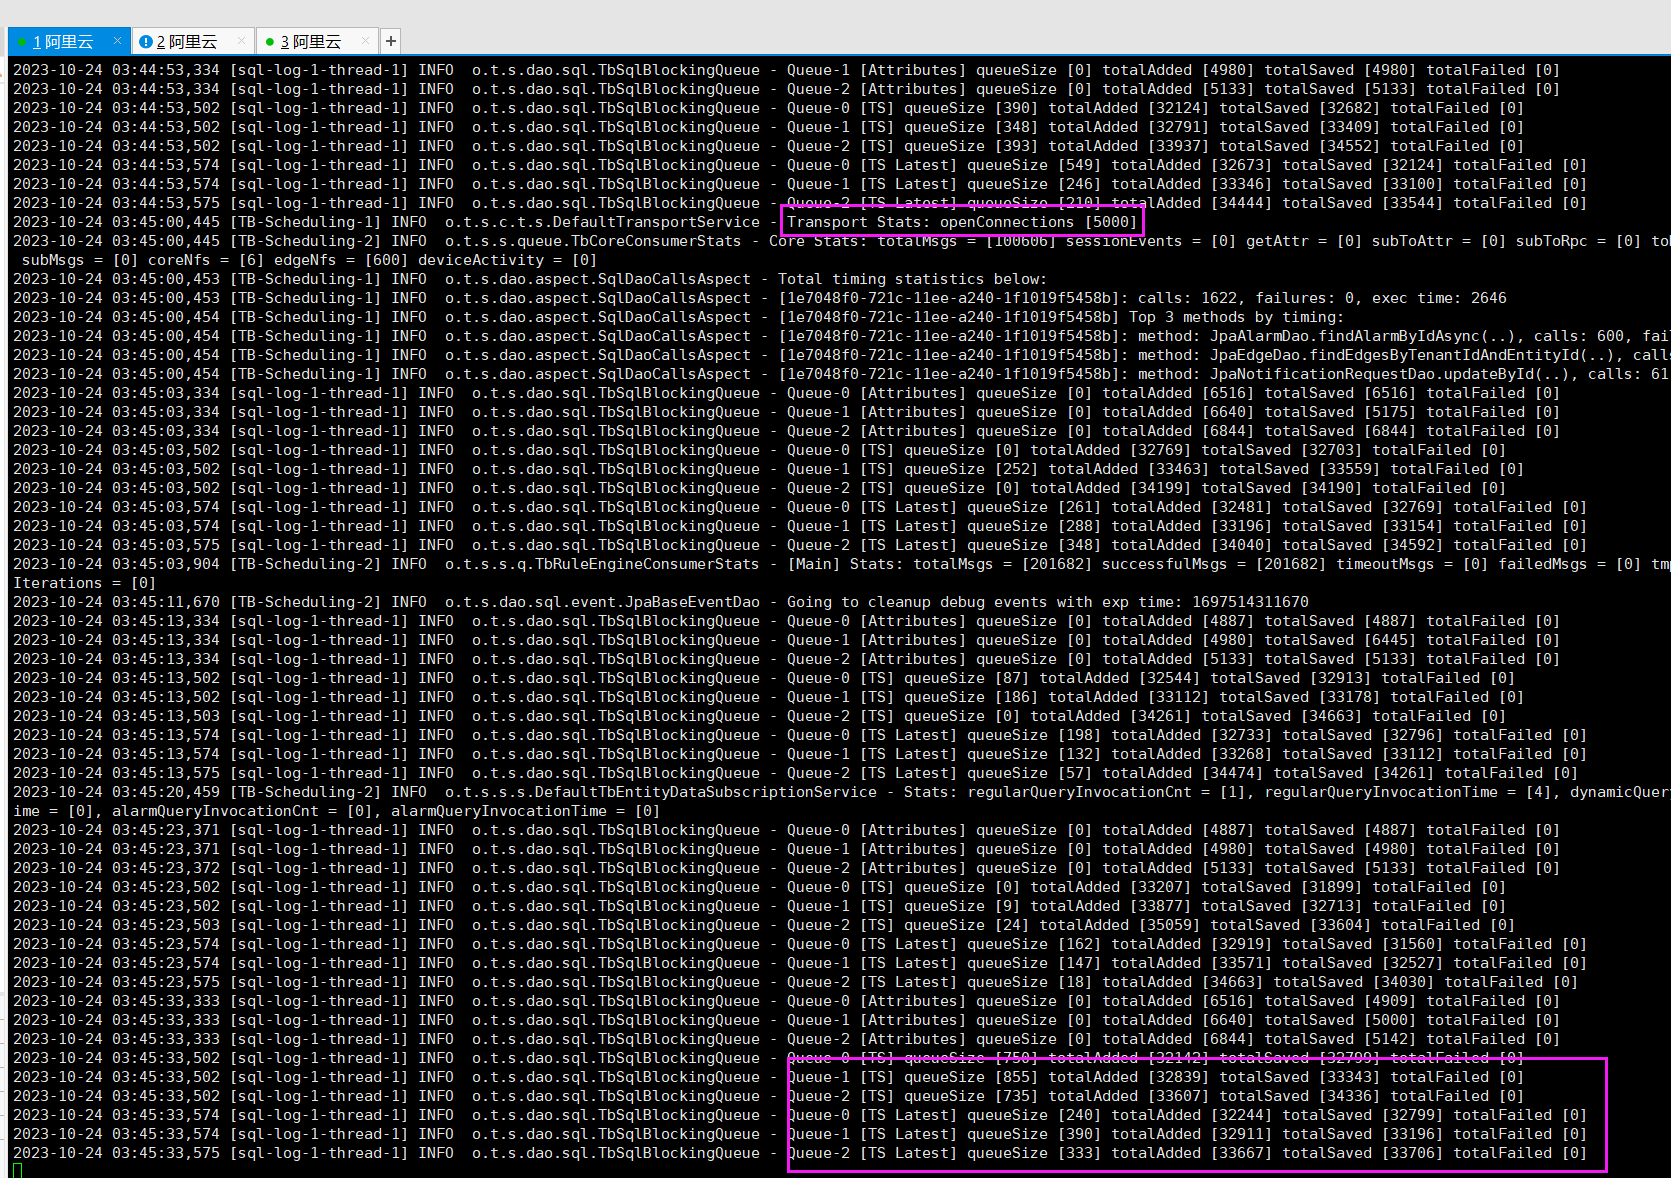
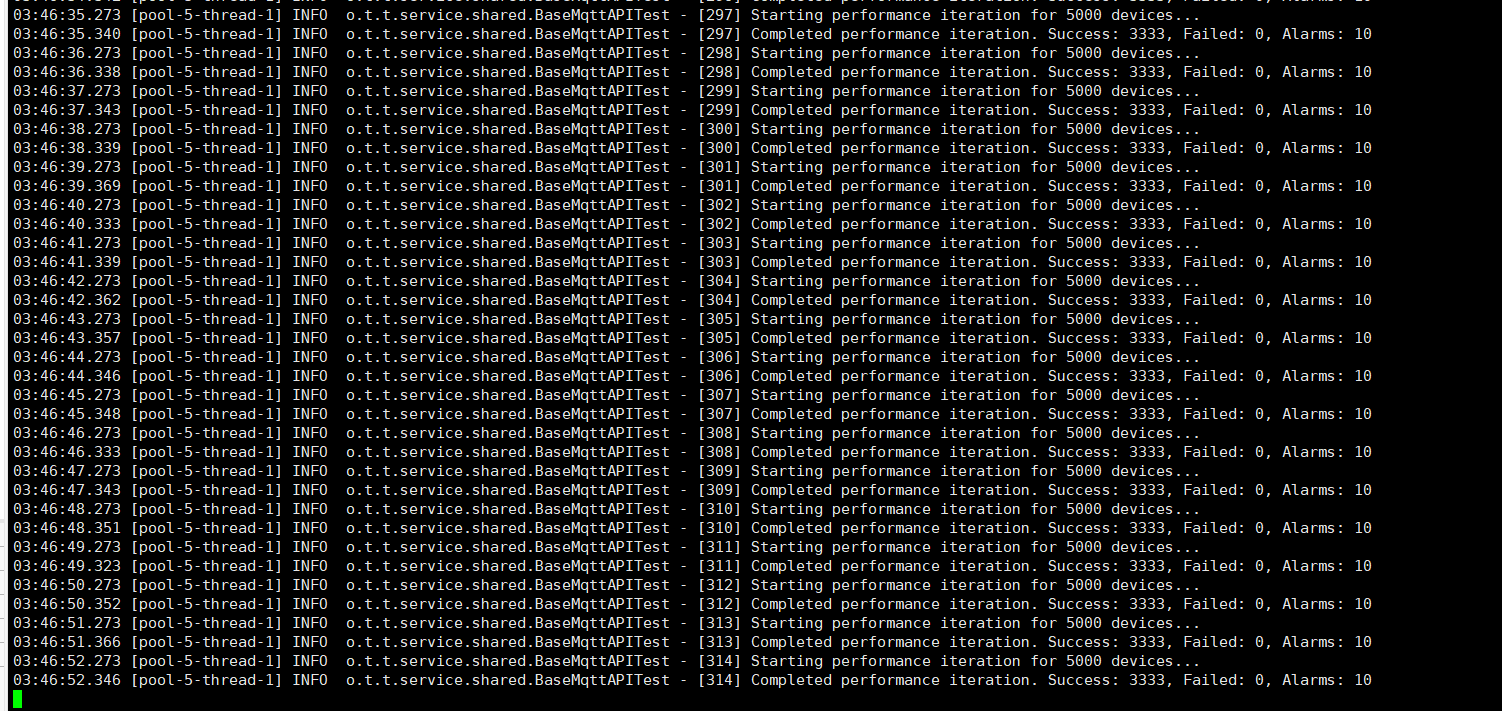
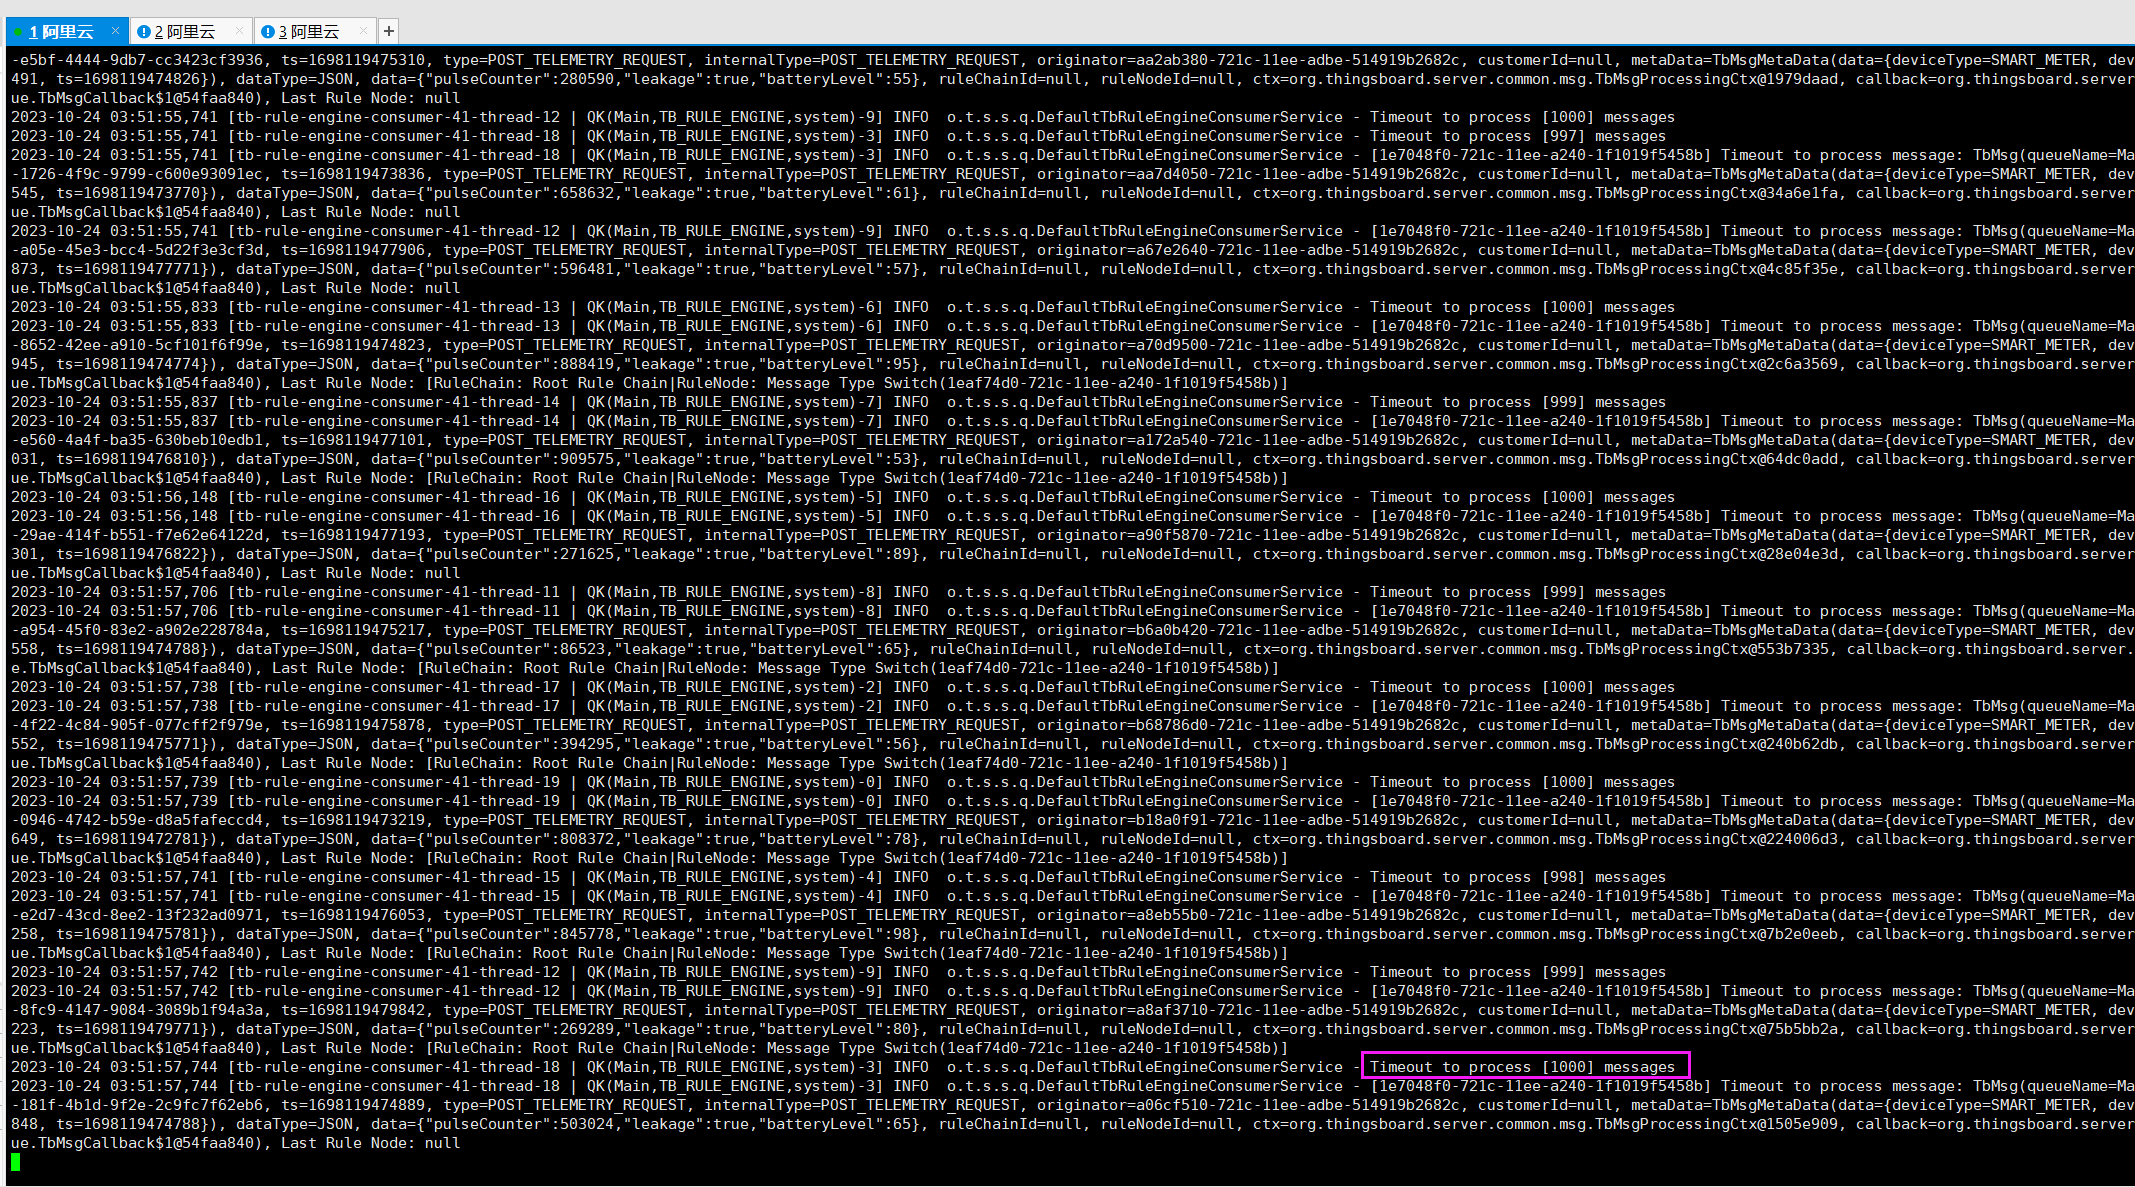
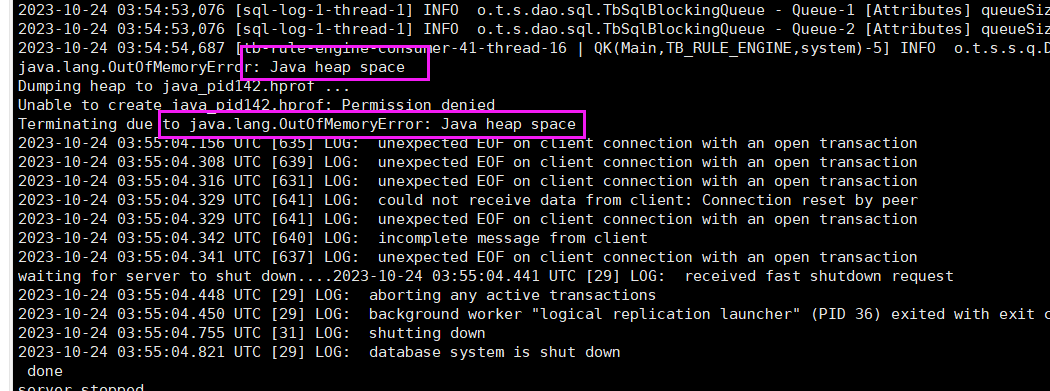
×10 峰值: 10000 msg/s → 约 30000 点/s → 出现超时、内存溢出:
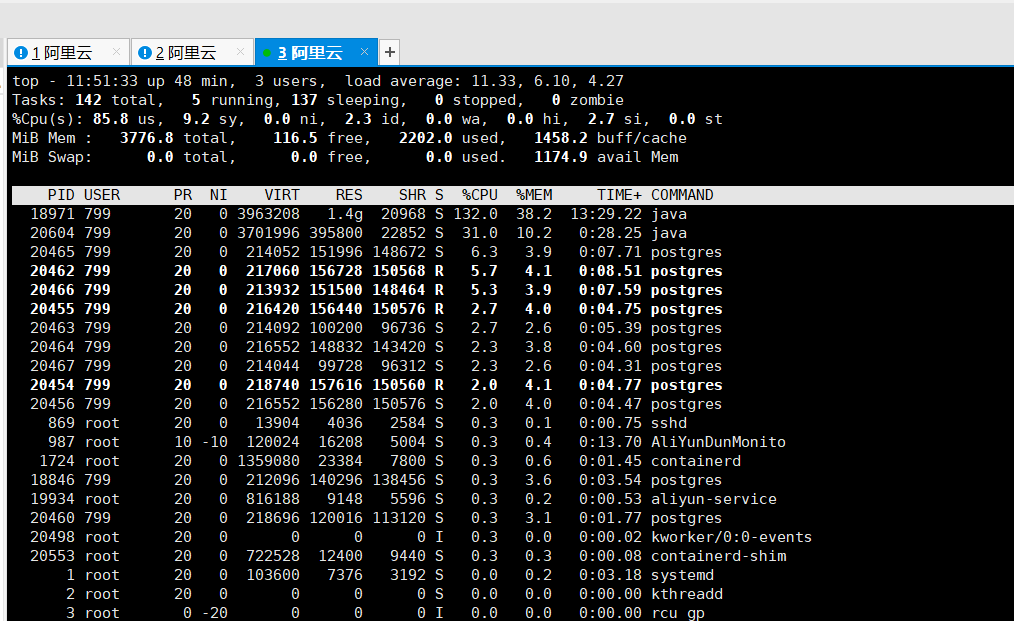
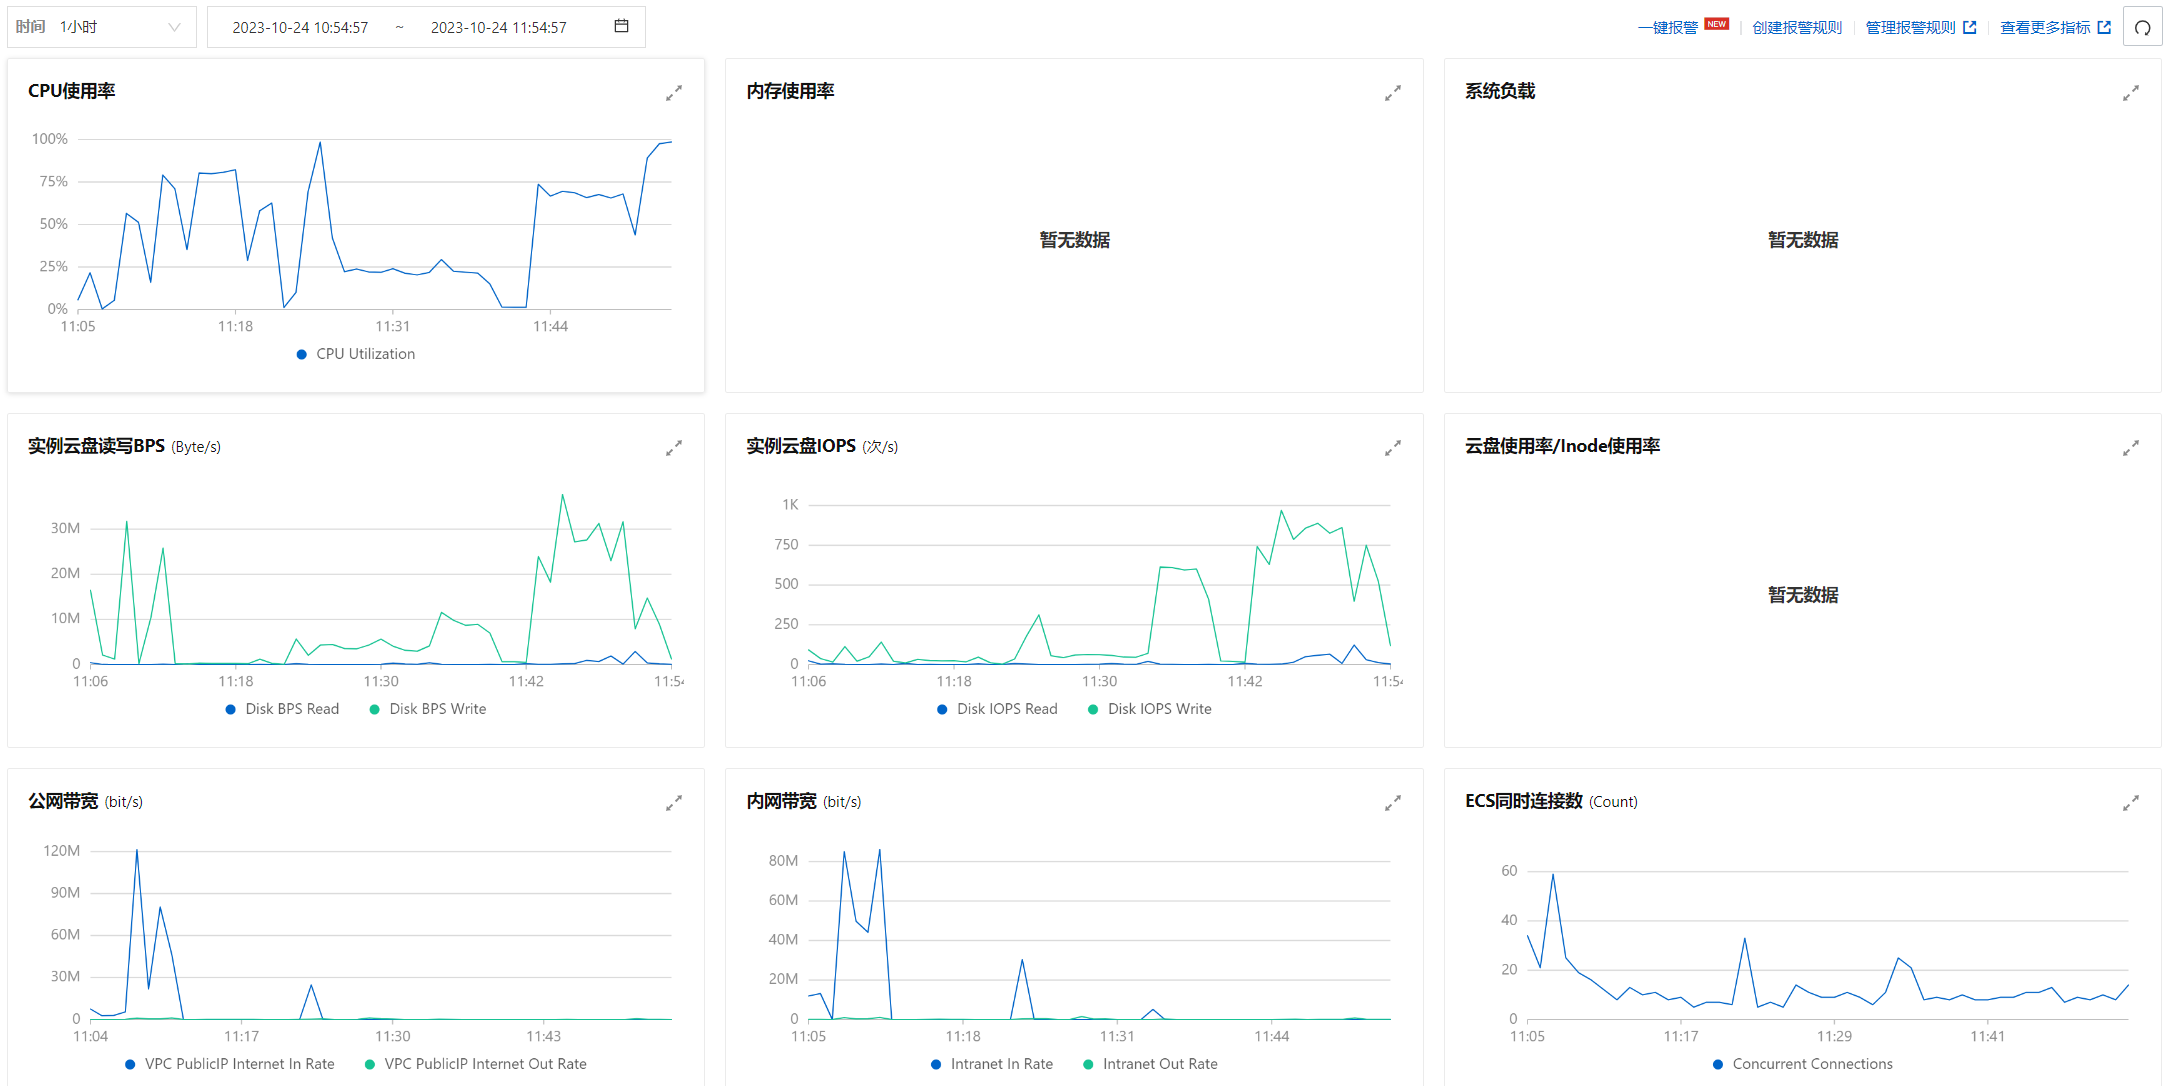
二、场景 B:Kafka + Postgres
| 项 | 值 |
|---|---|
| 机器 | 2 核 8G |
| 负载 | 5000 msg/s → 15000 点/s |
| 队列 | Kafka |
Compose 增加 Zookeeper + Kafka,TB_QUEUE_TYPE: kafka,并调 TB_KAFKA_BATCH_SIZE、LINGER_MS、MAX_POLL_RECORDS 等;TB JAVA_OPTS 约 -Xmx3072M。
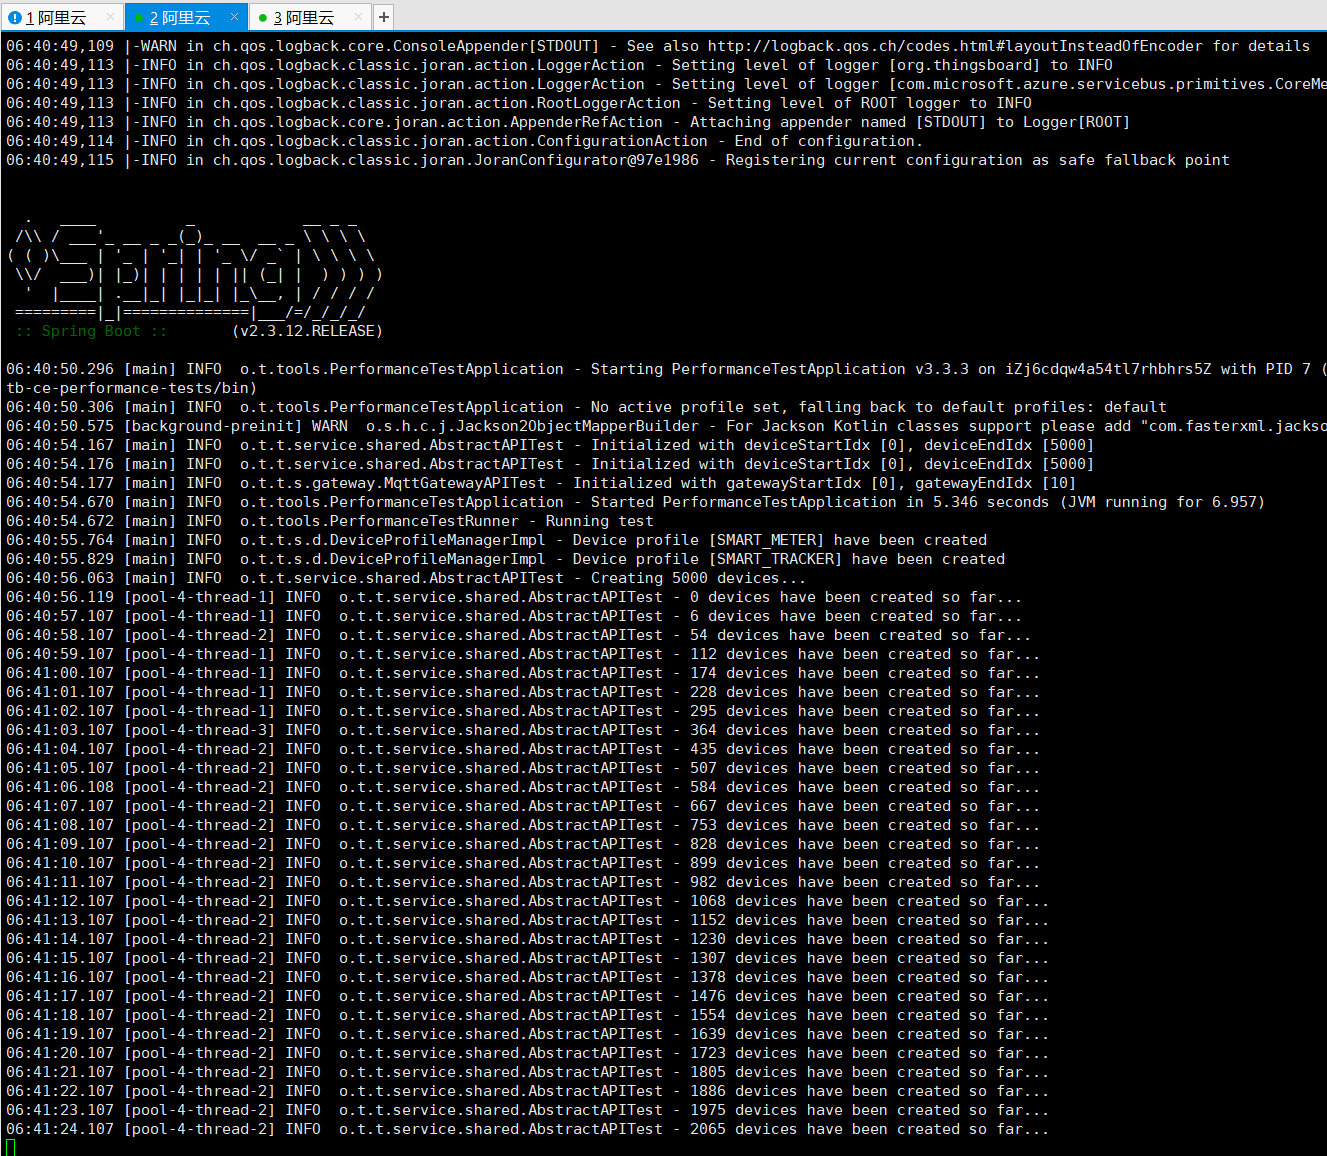
结果:创建设备、连接、发数过程见下;存在超时,遥测约 2 秒延迟;Main 跳过失败后超时消息会重试。
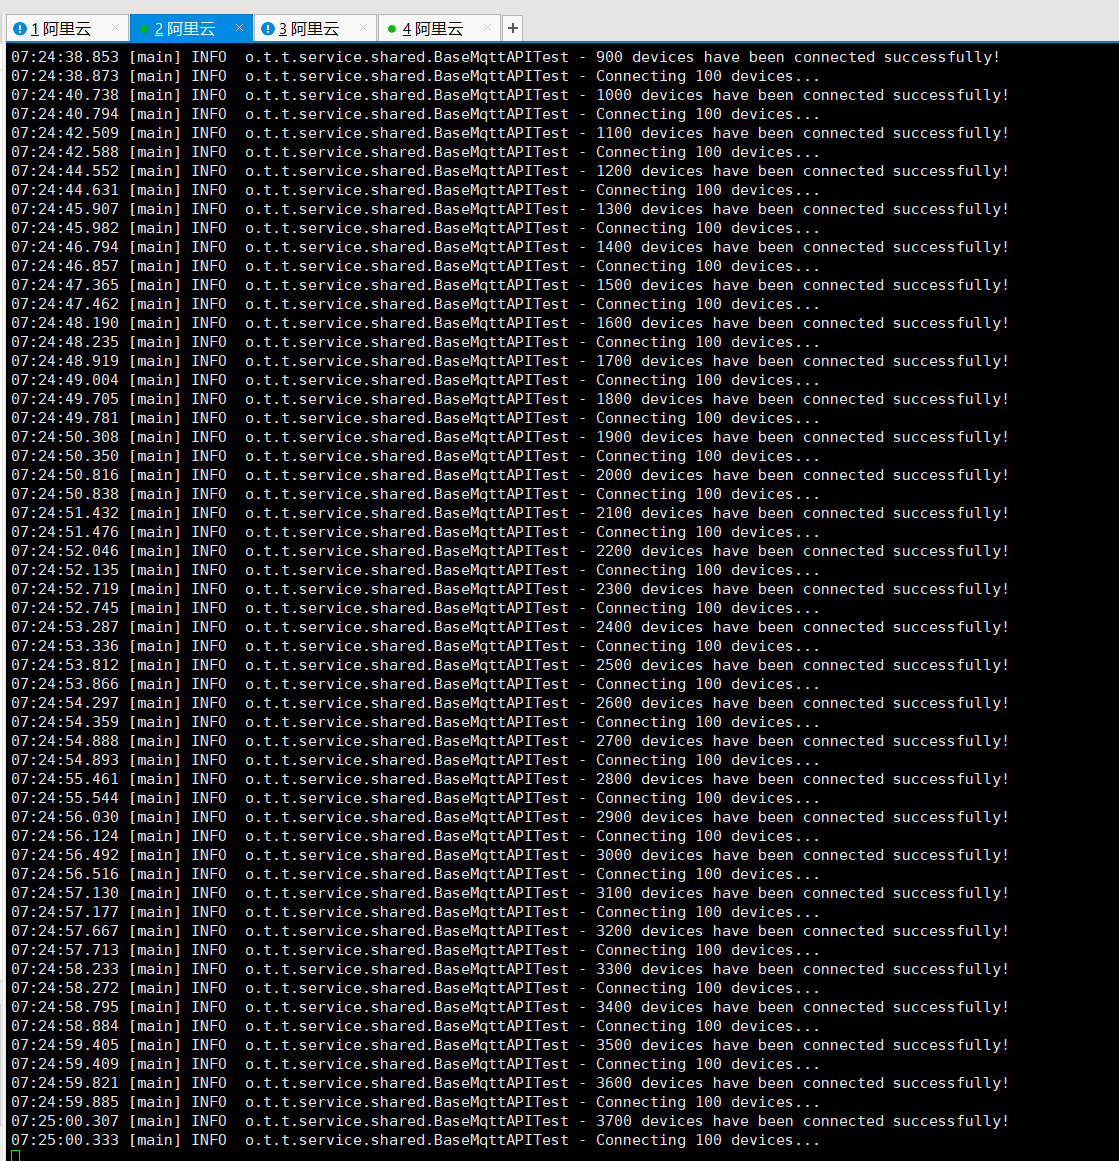
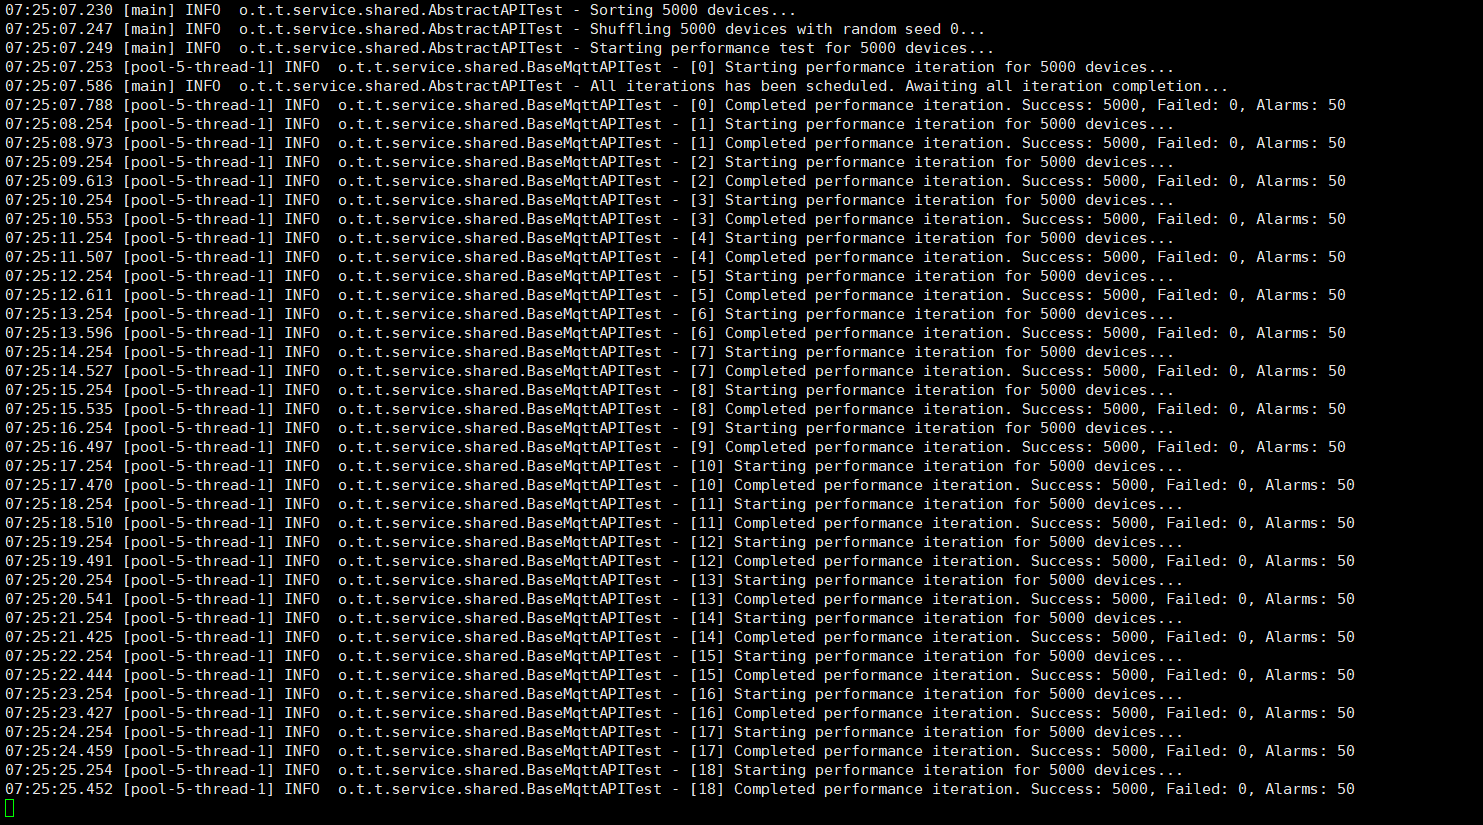
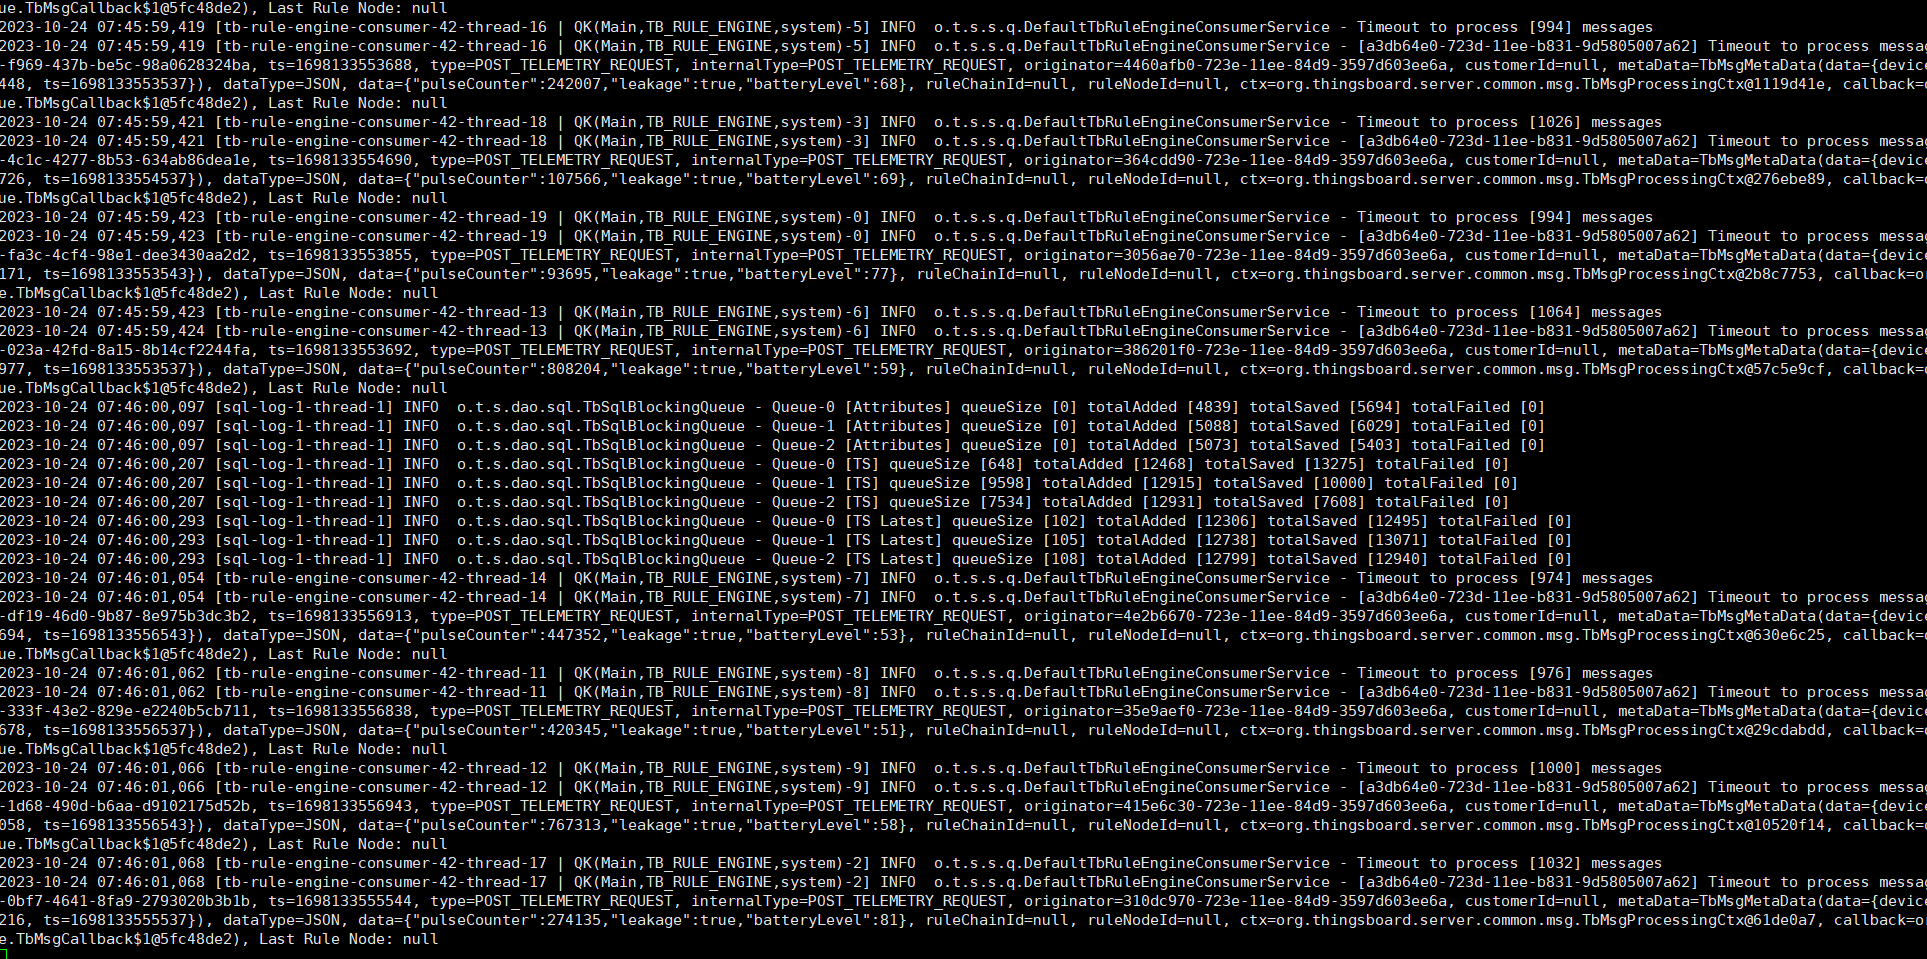
×3 峰值(更高 msg/s):系统满负荷,有超时但无失败(原稿结论)。
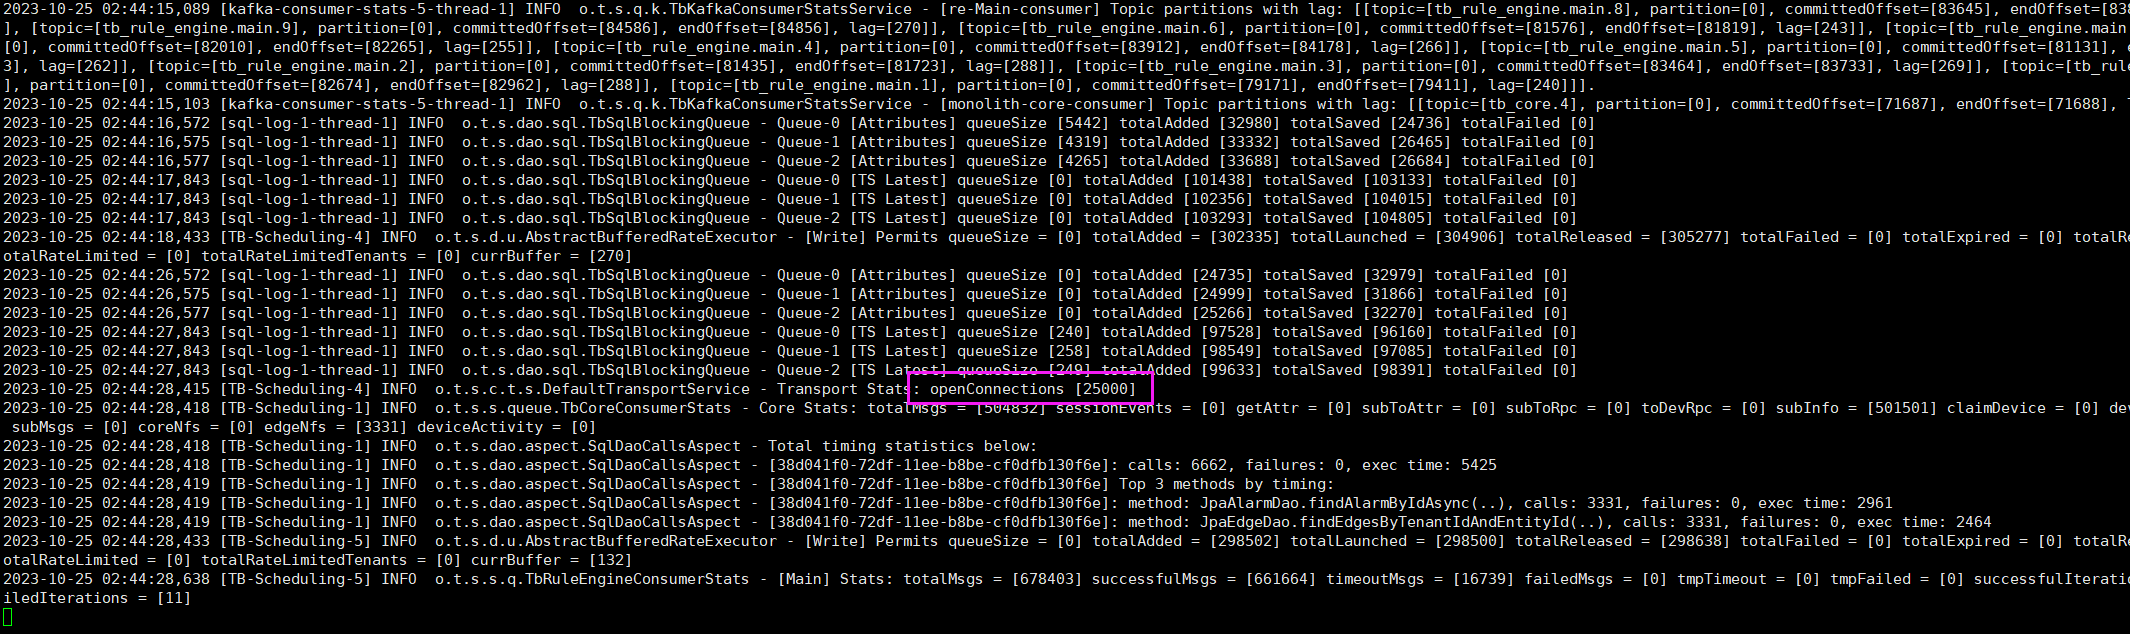
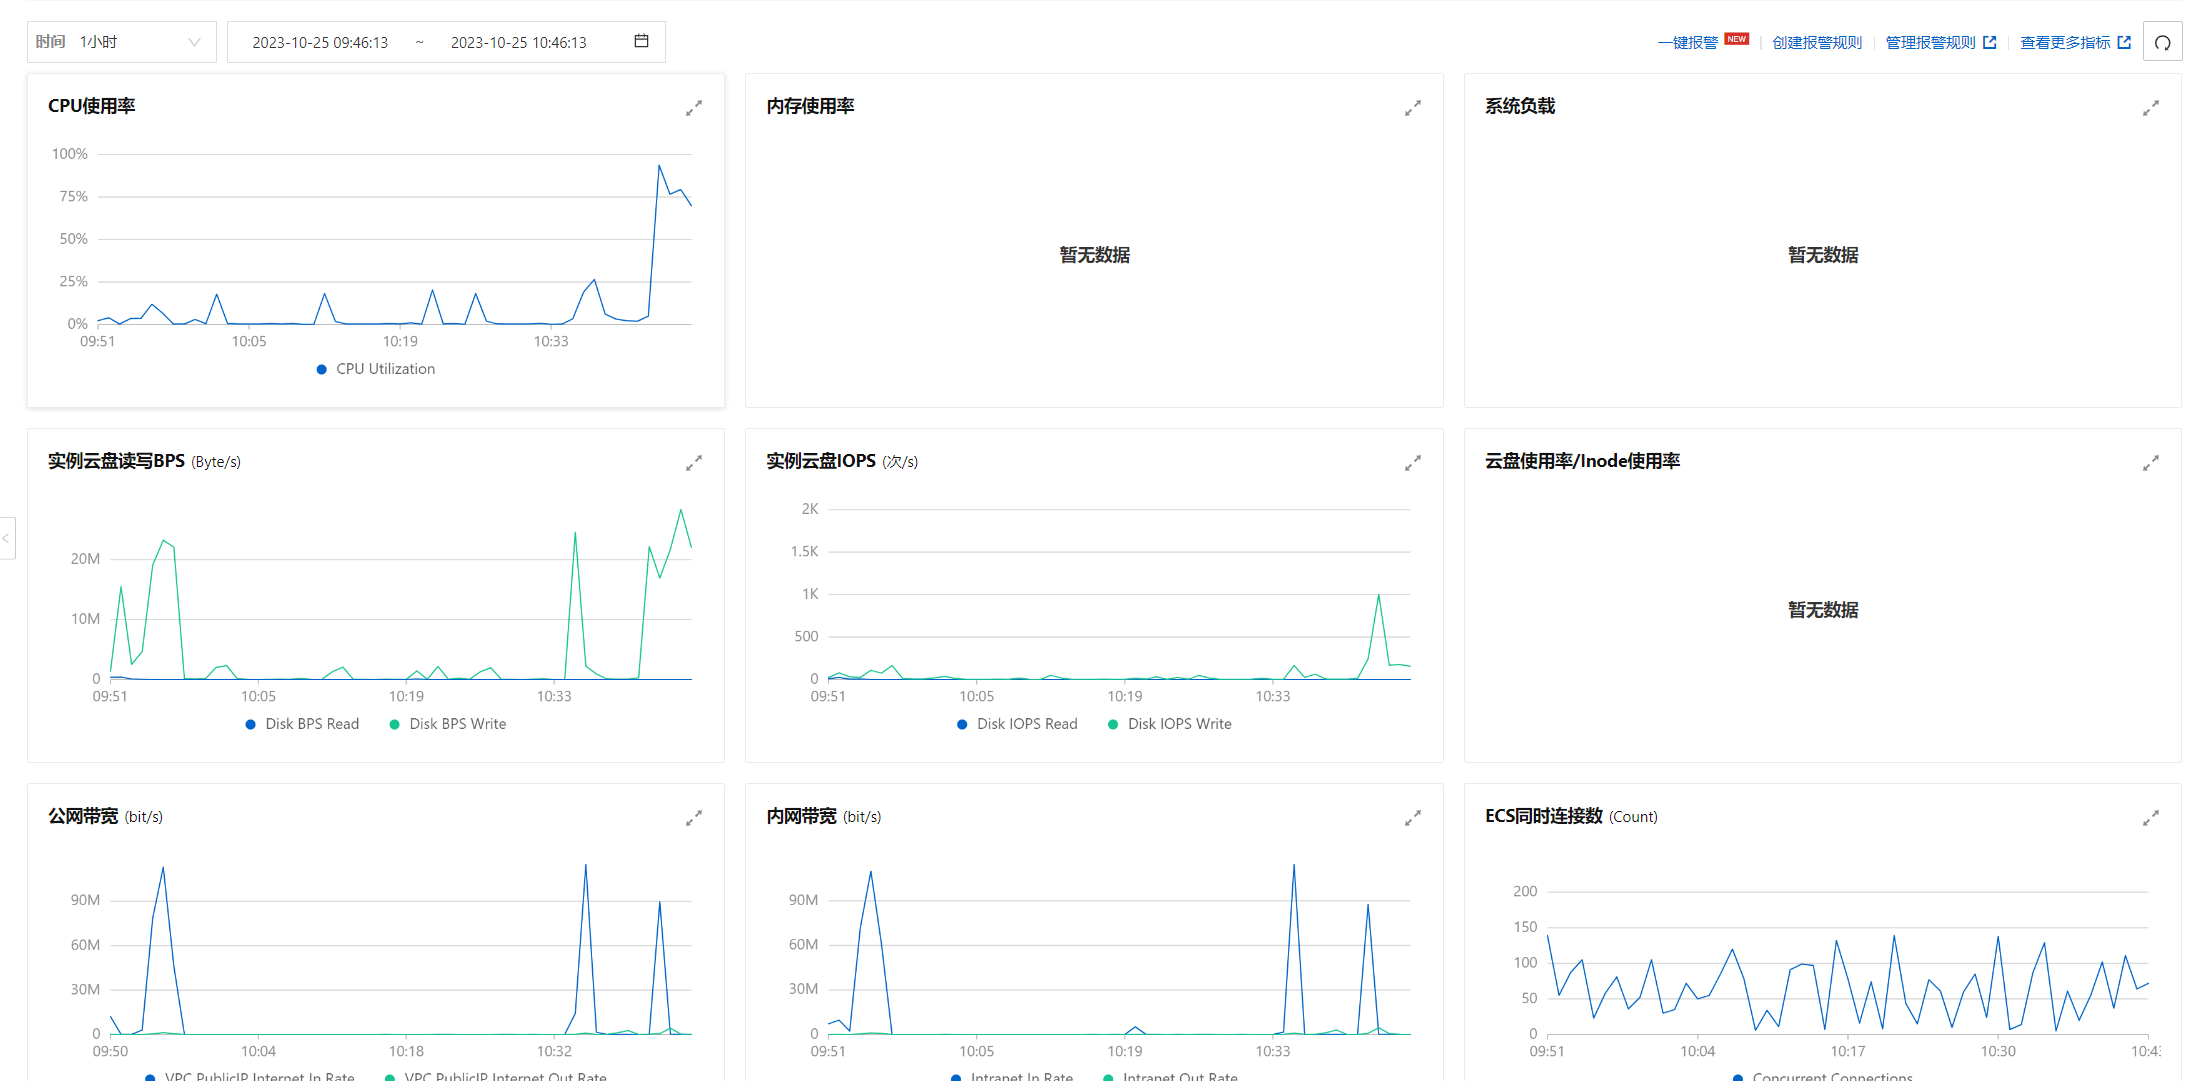
三、场景 C:Cassandra + Kafka + Postgres
| 项 | 值 |
|---|---|
| 机器 | 8 核 32G |
| 设备 | 25000 |
| 负载 | 10000 msg/s → 30000 点/s |
| 存储 | PG 存实体/属性/最新值;Cassandra 存历史时序;Kafka 队列 |
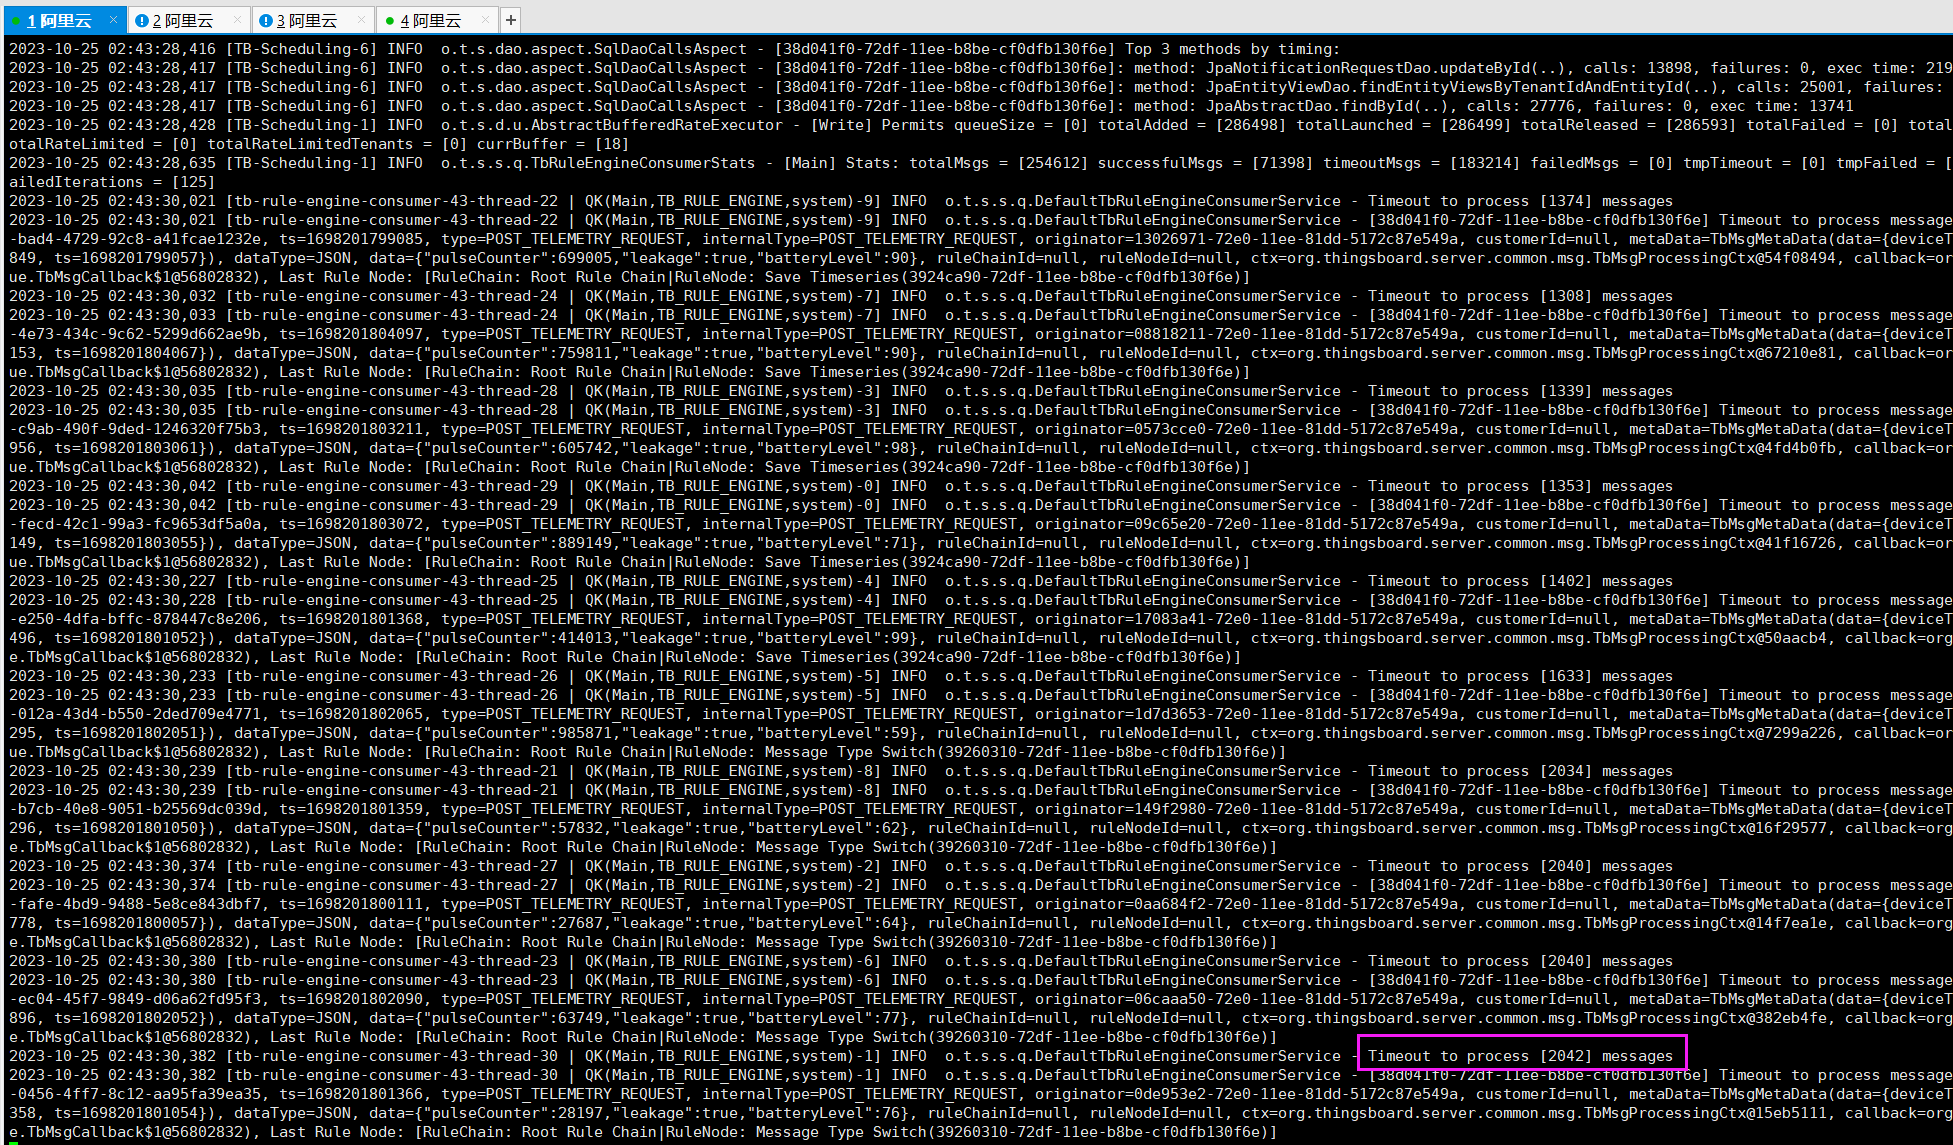
结果示意:
四、场景 D:10 万设备(较低 msg/s)
| 项 | 值 |
|---|---|
| 机器 | 8 核 32G |
| 设备 | 100000 |
| 负载 | 5000 msg/s → 15000 点/s |
| 存储 | Cassandra + Kafka + Postgres |
(Compose / 启动步骤与场景 C 同类,调设备数与 MESSAGES_PER_SECOND。)
五、场景 E:10 万设备 + 更高吞吐与调优
| 项 | 值 |
|---|---|
| 设备 | 100000 |
| 负载 | 10000 msg/s → 30000 点/s |
原稿观察:平均约能处理 9k/s,CPU ~90%,瓶颈在 PostgreSQL——每条消息更新属性 lastActivityTime 在 100k 设备下过重。
改进: 将设备状态持久化到 Cassandra 遥测:
PERSIST_STATE_TO_TELEMETRY: "true"(默认 false:状态写在 Postgres 的 server scope 属性。)
同时可加大 Cassandra heap 等(原稿 Compose 中 HEAP_NEWSIZE / MAX_HEAP_SIZE 等)。
补充(辅)
| 结论方向 | 说明 |
|---|---|
| 小规模 | 单机 Postgres + 内存队列可支撑约数千点/s 量级(视硬件) |
| 抬吞吐 | 上 Kafka;再抬历史写入上 Cassandra |
| 超大规模 | 避免高频写 PG 属性;PERSIST_STATE_TO_TELEMETRY 等官方调优项 |
| 对照 | 压测最新遥测、跳过最新遥测 |
完整 Compose 与多轮脚本以原稿/官方 Performance 文档为准;本文保留场景参数、关键环境变量与结果图。